
Do Primeiro wx+b até Aqui: Fechando o Curso
Vinte posts atrás, o primeiro lab dessa playlist era só isso: f(x) = wx + b, o modelo mais simples que existe. Terminei agora o primeiro curso da especialização, Supervised Machine Learning: Regression and Classification, e antes de seguir pro próximo, vale parar e olhar pra trás: o que realmente ficou de pé de tudo isso?
O fio que atravessa a playlist inteira
Se tem uma coisa que eu não esperava quando comecei, é o quanto pouca coisa nova eu realmente precisei aprender depois do meio do curso. Repara no padrão:
- Gradiente descendente apareceu pela primeira vez pra regressão linear, e quando voltou pra classificação, o loop era byte a byte o mesmo. Só a derivada de dentro mudou, porque
ftrocou de reta pra sigmoide. - Features polinomiais, o truque de tratar
x²,x³como se fossem variáveis novas, apareceu na regressão e voltou, sem mudar a ideia central, na classificação, só que agora curvando uma fronteira de decisão em vez de uma curva de ajuste. - Overfitting e regularização também não são conceitos exclusivos de um tipo de problema: a mesma decoreba que estraga uma curva de regressão estraga uma fronteira de classificação do mesmo jeito, e a mesma penalidade
+ (lambda/2m) * soma(w²)resolve os dois. - O scikit-learn ficou esperando no fundo o tempo inteiro. Toda vez que eu terminava de construir alguma coisa à mão, o próximo lab mostrava a mesma coisa em três linhas, pra regressão e pra classificação, sempre com aquele detalhe a mais (regularização por padrão) que só fazia sentido depois de eu já ter sentido a falta dela.
Isso muda como eu penso no curso inteiro: não foram "regressão" e "classificação" como dois assuntos separados, foi um conjunto pequeno de ferramentas (gradiente descendente, mapeamento de features, regularização) que eu vi funcionar em dois problemas diferentes. Aprender a ferramenta uma vez rendeu duas vezes.
O que eu levo desse curso
A regressão linear com uma variável parece brinquedo de tão simples, mas foi ali que apareceu toda a maquinaria que sustentou o resto: função de custo, derivada parcial, taxa de aprendizado, convergência. Quando a classificação chegou na Semana 3, a única coisa genuinamente nova foi a sigmoide amassando a saída entre 0 e 1, tudo o mais era a mesma maquinaria rodando por baixo. E o curso termina exatamente onde eu esperava menos: overfitting não é bug, é o preço de dar flexibilidade demais pro modelo, e regularização não é mágica, é só um jeito de dizer "confia nos dados, mas não confia demais".
O certificado
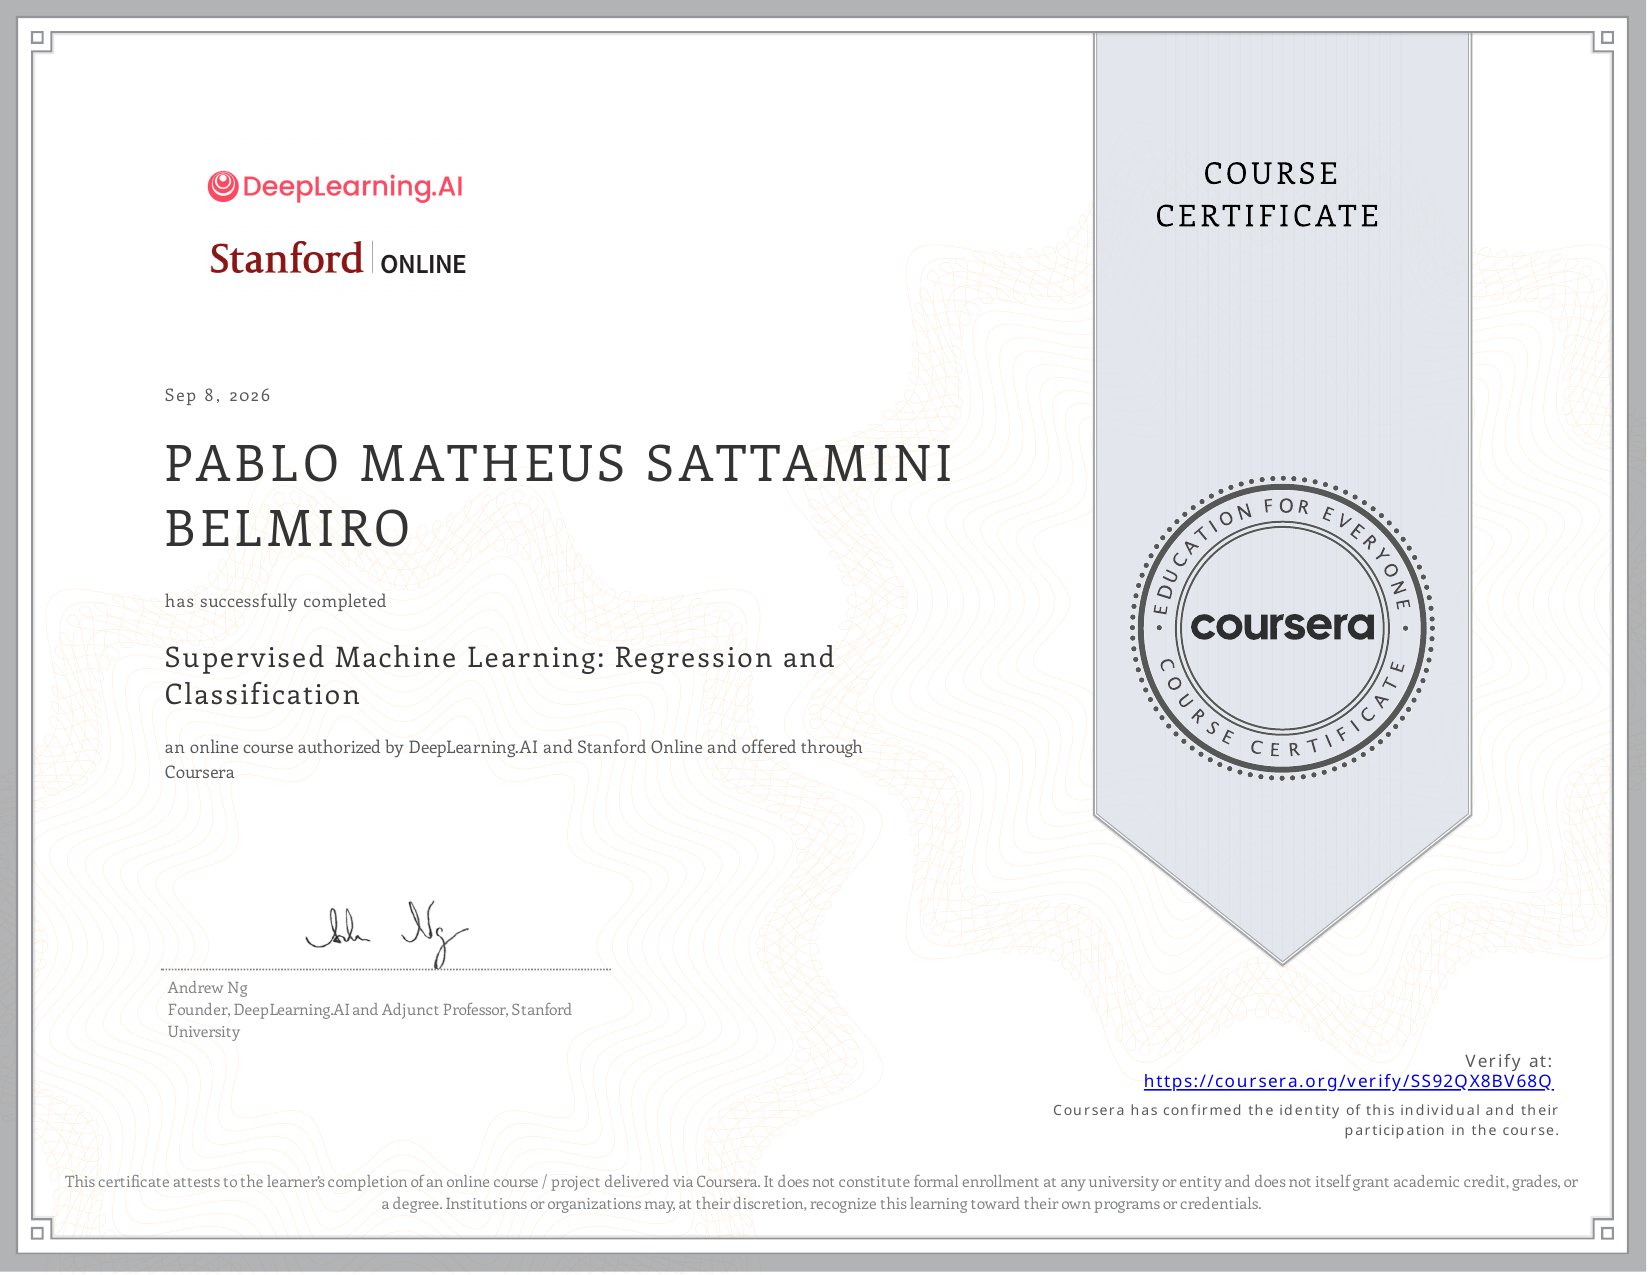
Baixar o PDF · Verificar na Coursera
E agora
Essa playlist fecha aqui por enquanto, mas a especialização do Andrew Ng continua (Redes Neurais e Árvores de Decisão vêm no próximo curso, Aprendizado Não Supervisionado e Sistemas de Recomendação no terceiro). Se eu seguir estudando, tem post novo. Enquanto isso, valeu por acompanhar até aqui, desde a reta que não bastava pra classificar câncer de mama até a fronteira regularizada que fechou o curso.